Meta e i contenuti dei siti per l’AI: la CMA britannica indaga sulle condizioni commerciali contestate dagli editori, sospese in attesa della consultazione.
La Competition and Markets Authority, l’autorità britannica per la concorrenza, ha aperto il 30 ottobre 2026 un’indagine sulle nuove condizioni commerciali che Meta applica alle aziende che usano Facebook, Instagram, WhatsApp e Threads per scopi professionali. Secondo la CMA, alcune clausole potrebbero consentire al gruppo di raccogliere contenuti dai siti di imprese ed editori e di impiegarli nei propri prodotti, comprese le funzionalità di intelligenza artificiale, senza lasciare a quelle aziende una scelta reale su se e come i loro materiali vengano usati. L’introduzione delle modifiche è sospesa; l’autorità deve ancora accertare se siano state violate le regole della concorrenza.
Meta respinge l’impostazione: secondo un portavoce non ci sono i presupposti per un’indagine, perché l’azienda si è già impegnata a non modificare le condizioni senza consultare editori e altri soggetti interessati.
Per un editore, essere su Facebook significa anche lavorare su un pubblico costruito nel tempo: lettori che riconoscono la testata, seguono gli aggiornamenti, condividono gli articoli. Rinunciare alla pagina può comportare la perdita di una parte di quel rapporto. Le contestazioni partono da qui: il timore che continuare a usare gli strumenti commerciali della piattaforma richieda di concedere permessi anche sui contenuti pubblicati sul proprio dominio.
La CMA dovrà stabilire prima di tutto se Meta detenga una posizione dominante in un mercato rilevante nel Regno Unito; solo in quel caso valuterà se le condizioni ne costituiscano un abuso. Il procedimento riguarda quindi anche il margine di scelta di chi riceve il contratto e le conseguenze di un eventuale rifiuto, visto che l’alternativa prevista è rinunciare all’uso commerciale delle piattaforme.
Indice dei contenuti
Che cosa prevedono le condizioni commerciali di Meta
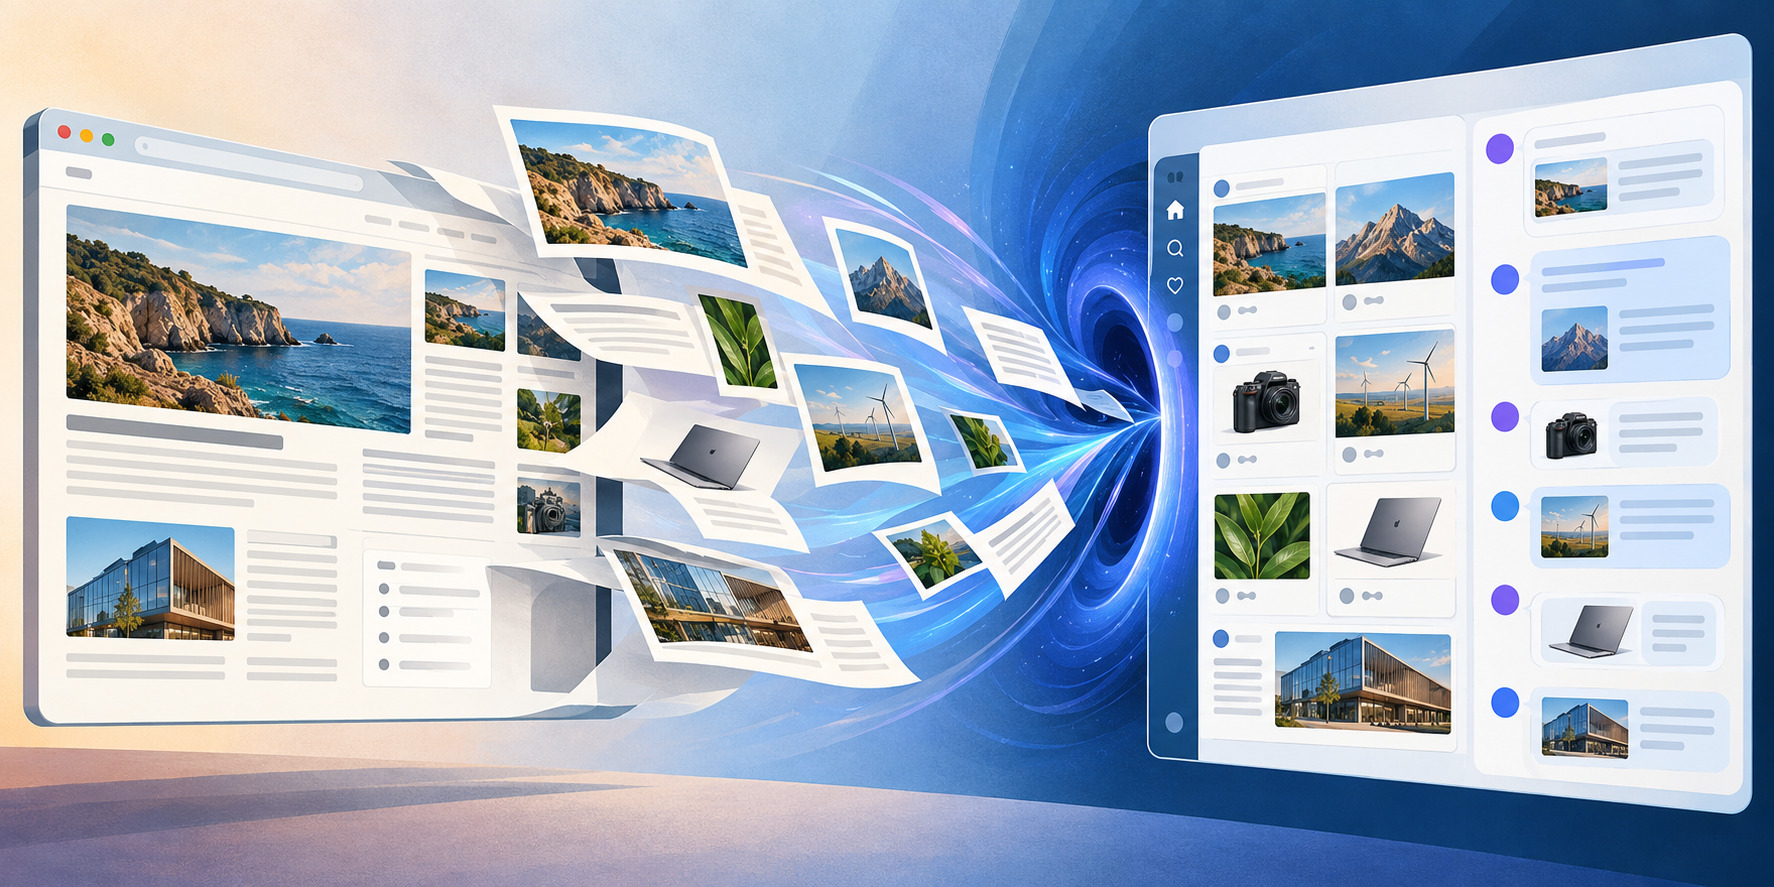
Nella ricostruzione di WAN-IFRA, l’associazione mondiale degli editori di notizie, la clausola autorizzerebbe Meta a usare strumenti automatici e credenziali di prova per accedere ai siti associati a qualunque attività che si serva dei suoi servizi, continuando nel tempo a raccoglierne gli aggiornamenti. Per le testate con contenuti riservati agli abbonati, il riferimento alle credenziali è il passaggio che pesa di più.
Il perimetro contestato comprende dunque materiali che un’azienda potrebbe non aver mai pubblicato direttamente sui social. Una testata condivide il collegamento a un’inchiesta; sul sito rimangono l’articolo integrale, le fotografie, i documenti, l’archivio. Un produttore promuove un servizio; sul suo dominio si trovano guide, schede tecniche, confronti e risposte preparate dai suoi specialisti. A preoccupare chi contesta le condizioni è l’accesso a questo patrimonio.
Ladina Heimgartner, presidente di WAN-IFRA, ha dichiarato (traduzione nostra):
«Il giornalismo non è materia prima da raccogliere come condizione per essere presenti su una piattaforma».
Gli editori chiedono tre garanzie scritte nel contratto: poter rifiutare l’autorizzazione alla raccolta senza perdere l’accesso agli strumenti business di Meta; rendere vincolanti le istruzioni di robots.txt; subordinare a una licenza ogni impiego dei contenuti per sviluppare o alimentare sistemi AI.
La loro obiezione riguarda il prezzo effettivo della presenza sulla piattaforma: oltre al tempo dedicato a gestire un account e al denaro investito nelle campagne, potrebbero entrare nel rapporto commerciale anche diritti sui materiali prodotti altrove.
Crawling, indicizzazione e addestramento AI: che cosa cambia
Per comprendere la portata della clausola bisogna seguire il percorso del contenuto. Un crawler è un programma che visita automaticamente le pagine web; può leggerle, seguirne i collegamenti e tornare a controllare se siano state aggiornate. I motori di ricerca lo usano per esplorare il web e costruire i propri indici.
Dalla stessa raccolta possono partire attività molto diverse. Indicizzare significa rendere le informazioni ritrovabili; recuperarle per una risposta significa consultarle quando arriva una richiesta. Nell’addestramento, invece, i dati entrano in un processo che modifica i parametri di un modello. L’autorizzazione a visitare una pagina e quella a usarne il contenuto per un determinato prodotto vanno quindi lette alla luce delle finalità previste.
La formulazione delle clausole è cambiata durante la controversia. Nieman Lab, che ha rivelato il caso il 15 ottobre, ha documentato che il giorno successivo Meta ha eliminato il riferimento esplicito all’addestramento e ha circoscritto l’uso dei contenuti raccolti ai prodotti pubblicitari e business. Gli editori ritengono che la nuova formulazione lasci comunque aperti impieghi nei servizi AI collegati a quei prodotti; l’avvocato Matt Topic, interpellato dalla testata, osserva che «prodotto business» non sembra un termine definito e che «sviluppare» è un verbo abbastanza ampio da comprendere l’addestramento.
Questa sequenza impedisce di descrivere la vicenda come un’autorizzazione già acquisita ad addestrare qualunque modello su qualunque sito. Si discute di condizioni proposte e modificate, la cui introduzione è stata fermata mentre le parti ne contestano portata ed effetti.
La posizione di Meta e gli accessi necessari ai servizi
Meta sostiene che l’aggiornamento raccolga in un unico testo disposizioni prima distribuite in documenti diversi e che non cambi il modo in cui l’azienda visita i siti. Nelle dichiarazioni riportate da Nieman Lab, precisa che le clausole riguardano pubblicità e servizi business e che i proprietari dei siti possono continuare a indicare le proprie preferenze attraverso robots.txt.
L’accesso alle pagine esterne ha anche funzioni ordinarie: leggere un titolo e una descrizione per mostrare l’anteprima di un link, oppure recuperare informazioni su un prodotto. La discussione deve tenere conto di queste esigenze; per chi usa il servizio, resta da capire quanto si estenda il permesso rispetto all’attività richiesta.
Un’impresa che acquista pubblicità per una guida ha interesse a facilitarne la lettura e la distribuzione. Altri impieghi della stessa guida richiedono una valutazione diversa, perché possono incidere sulla sua capacità di attirare visite, generare contatti, distinguere l’azienda dai concorrenti. Finalità e limiti devono essere comprensibili anche a chi accetta le condizioni per continuare a lavorare senza disporre di un ufficio legale interno.
Robots.txt: le istruzioni ai crawler e il contratto
Robots.txt è il file con cui il gestore di un sito indica ai programmi automatici quali percorsi visitare e quali escludere. Consente di dare istruzioni differenti a crawler diversi, lasciando disponibili alcune funzioni e limitandone altre.
Lo standard RFC 9309 chiarisce che queste regole non costituiscono un’autorizzazione all’accesso: sono istruzioni che i crawler sono chiamati a rispettare, mentre per proteggere risorse riservate servono autenticazione e controlli sul server.
La PPA, associazione britannica degli editori di riviste e media specializzati, solleva un problema ulteriore: le rassicurazioni di Meta sul rispetto di robots.txt non compaiono nelle condizioni. La richiesta è di inserirle nel contratto, rendendo riconoscibili i limiti dell’autorizzazione concessa. Lo European Publishers Council aggiunge che gli editori devono sapere quale agente automatico stia operando, per conto di chi e con quale finalità.
Per chi gestisce un sito, la configurazione tecnica e gli accordi con la piattaforma vanno valutati insieme. Bloccare un programma attraverso robots.txt esprime una scelta sull’accesso; sapere quali diritti siano stati concessi accettando un servizio richiede di esaminarne le condizioni, e l’esistenza del file non basta a risolvere questa seconda verifica.
Perché la CMA indaga sulla concorrenza
La vicenda interessa l’Antitrust perché l’accettazione di un contratto avviene dentro un rapporto economico preciso. Chi utilizza una piattaforma da anni può avervi investito denaro, organizzazione e lavoro; abbandonarla significa sostenere il costo di ricostruire almeno una parte di quell’attività.
Una pubblicazione locale può raggiungere attraverso Facebook lettori che difficilmente passerebbero dalla sua homepage. Un negozio può aver concentrato su Instagram campagne, catalogo e richieste dei clienti. Per queste realtà, la possibilità formale di smettere di usare il servizio va confrontata con la possibilità economica di farlo.
Il procedimento britannico dovrà verificare i presupposti giuridici di un eventuale abuso. La dipendenza di un singolo cliente, da sola, non dimostra una violazione; aiuta però a capire perché la raccolta dei contenuti venga discussa anche come condizione di accesso al mercato.
Un editore con un marchio forte, abbonati e più canali di distribuzione dispone inoltre di alternative diverse da quelle di una piccola testata specialistica: condizioni uguali per tutti possono incontrare capacità negoziali molto lontane.
Le modifiche sono sospese: la sequenza delle date
Meta ha comunicato le nuove condizioni l’8 ottobre, con entrata in vigore prevista per il 30 ottobre. Dopo la prima analisi di Nieman Lab e la rimozione del riferimento all’addestramento, il 23 ottobre l’azienda ha spostato la data al 20 novembre, mentre editori e inserzionisti chiedevano a Bruxelles e Londra di intervenire. Il 28 ottobre Meta ha annunciato una pausa per consultare il settore; lo stesso giorno il tribunale distrettuale di Oslo, su ricorso di dieci gruppi editoriali norvegesi fra cui NRK, Schibsted e TV 2, ha vietato in via cautelare l’introduzione delle modifiche in Norvegia fino a una decisione definitiva sulla loro legittimità. Due giorni dopo, la CMA ha aperto l’indagine.
Alla data del 1° novembre 2026 la sospensione non equivale a un ritiro delle clausole, come ha sottolineato la stessa WAN-IFRA nella lettera aperta inviata a Mark Zuckerberg il 29 ottobre. Il testo che emergerà dal confronto, e le modalità con cui potrà essere accettato o rifiutato, saranno determinanti per valutarne gli effetti.
Perché riguarda anche le aziende italiane
L’indagine britannica non introduce obblighi nuovi per le imprese italiane, ma la partita europea è aperta. Lo European Publishers Council ha scritto due volte alla Commissione chiedendo di esaminare le condizioni alla luce del Digital Markets Act e del diritto della concorrenza; le associazioni europee degli editori EMMA, ENPA, EPC e NME hanno sollecitato misure cautelari, e la Commissione ha confermato di aver ricevuto un reclamo e di valutarlo. Il caso norvegese mostra inoltre che un tribunale nazionale può fermare l’introduzione delle clausole prima di qualunque decisione delle autorità.
Il caso merita attenzione anche per un motivo più quotidiano: porta alla luce una decisione che può passare attraverso la gestione ordinaria di un account, cioè concedere permessi sui contenuti del proprio sito per continuare a usare un servizio esterno.
Guide tecniche, fotografie, articoli e documentazione commerciale incorporano lavoro e competenze. Per un’impresa servono a farsi trovare, dimostrare esperienza, avviare una trattativa; per un editore finanziano, direttamente o attraverso pubblicità e abbonamenti, la produzione delle pubblicazioni successive.
Se quei materiali alimentano un servizio che soddisfa il lettore senza portarlo alla fonte, il ritorno economico cambia. Su Digitalic lo abbiamo raccontato a proposito dell’arrivo di Google AI Mode in italiano e del reclamo della FIEG ad AGCOM: la disponibilità di una risposta dentro la piattaforma modifica il percorso verso il sito che ha prodotto le informazioni.
Il caso delle condizioni commerciali va tenuto distinto da quello dei dati personali pubblicati dagli utenti sui social. Qui il confronto riguarda i permessi collegati all’uso professionale dei servizi e ai siti associati; cambiano i testi da esaminare e le decisioni richieste a chi li accetta.
Nelle aziende questa responsabilità può essere distribuita fra marketing, agenzia, amministratori degli account e gestori del sito. Ricostruire chi accetta gli aggiornamenti, quali domini siano collegati e quali contenuti possano essere interessati permette almeno di assegnare la decisione a chi ne conosce le conseguenze.
Che cosa dovrà chiarire il confronto con gli editori
Gli editori chiedono di discutere separatamente la presenza sulle piattaforme e l’uso dei contenuti esterni. Una licenza dedicata consente di negoziare materiali inclusi, finalità, durata, compensi e condizioni di cessazione; l’inserimento dei permessi nelle condizioni generali trasferisce invece queste scelte dentro il rapporto necessario a gestire l’account. Per valutare gli sviluppi servirà leggere il testo che Meta proporrà dopo la consultazione: se consentirà un rifiuto separato, quali garanzie riconoscerà alle istruzioni dei siti, come definirà gli impieghi nei prodotti AI e se varrà allo stesso modo nel Regno Unito, in Europa e negli altri mercati.