Sangfor porta in Sangfor HCI una cold migration che salta gli zeri, fino a 5 volte più rapida di VMware, e il memory tiering su NVMe contro la DRAM che rincara.
Per anni, spostare un disco virtuale da 3 TB in cui erano stati scritti poche centinaia di gigabyte ha significato copiare anche il vuoto. Gli strumenti tradizionali di migrazione leggono l’intero volume allocato, trasferiscono in rete regioni fatte soltanto di zeri e le riscrivono sul disco di destinazione, byte dopo byte, perché quello spazio era stato riservato. Gli zeri sono la porta d’ingresso di questa storia; il tema arriva subito dopo, e riguarda il prezzo della memoria.Sangfor Technologies ha introdotto nell’ultima release di Sangfor HCI, la piattaforma iperconvergente che l’azienda presenta ora anche come Sangfor Virtualization Stack, due funzioni che partono dallo stesso principio: smettere di pagare per ciò che non serve. La prima è un nuovo motore di cold migration e cloning, qemu-cp, che salta gli zeri e, nei test di laboratorio dell’azienda, trasferisce i dischi delle macchine virtuali fino a 5 volte più velocemente del workflow nativo di VMware. La seconda è il Memory Tiering su NVMe, che sposta su SSD le pagine di memoria inattive e consente di raddoppiare la RAM logica di un server senza comprare nuovi moduli DRAM. Arrivano nel momento in cui la DRAM per server è diventata uno dei componenti più cari del data center e molte aziende stanno pianificando l’uscita da VMware dopo il cambio di licenze introdotto da Broadcom.
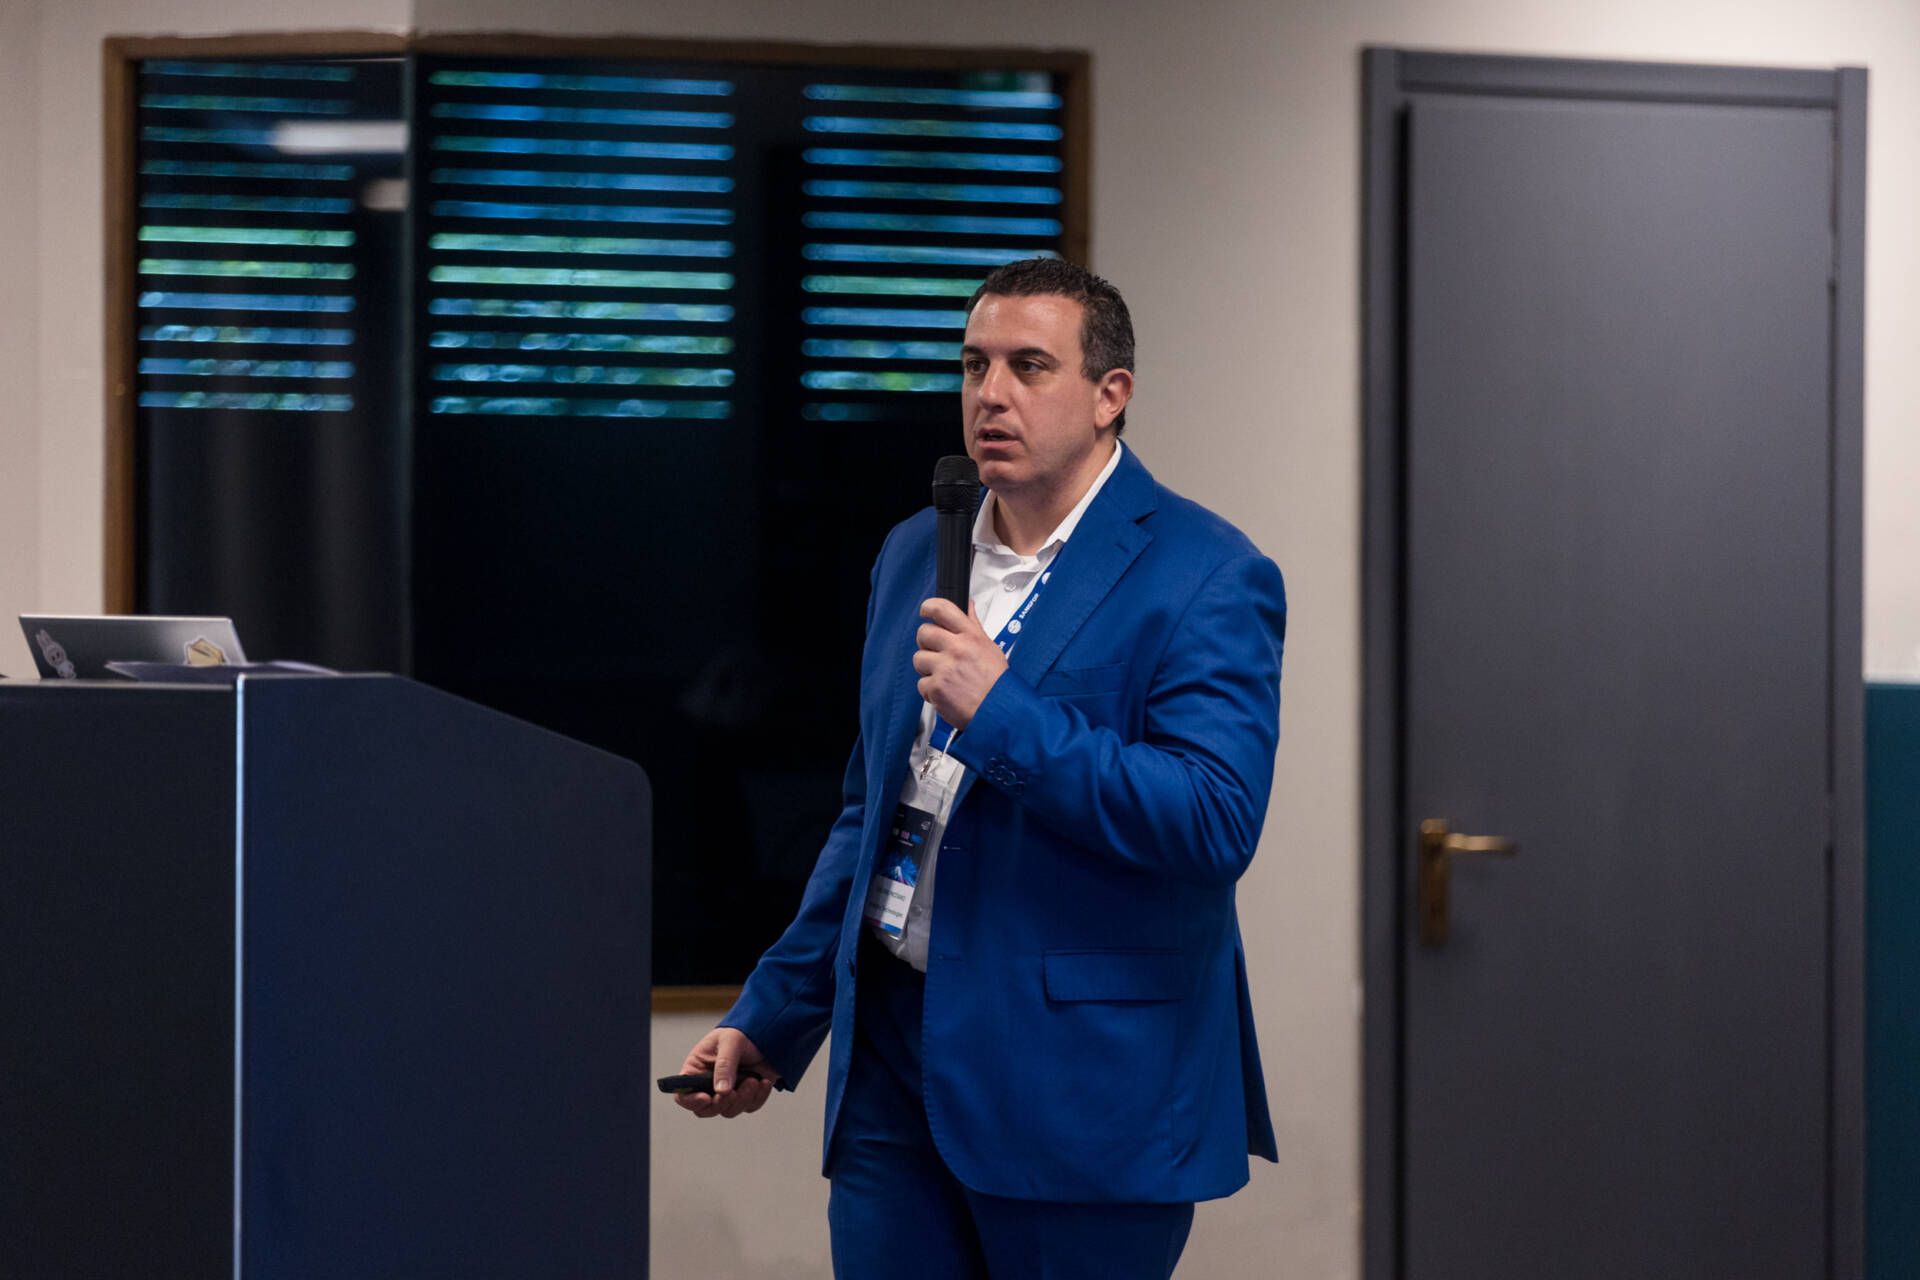
Simone Protano, Senior PreSales Manager di Sangfor Technologies
Il nome da tenere a mente è quello di Simone Protano, Senior PreSales Manager di Sangfor Technologies, che accompagna entrambe le novità. Una sua frase, in particolare, ci servirà più avanti: i miglioramenti della cold migration arrivano, dice, «senza compromettere la consistenza dei dati a livello di byte tra i dischi di origine e quelli di destinazione». Per ora mettiamola da parte.
Indice dei contenuti
Sangfor e la memoria che manca
Per capire perché un’azienda di virtualizzazione si mette a offrire memoria che fisicamente non c’è, bisogna tornare indietro di circa un anno, alla fine del 2025, quando i grandi cloud provider statunitensi iniziano ad anticipare gli ordini di DRAM per server, mentre i produttori spostano capacità verso la memoria HBM degli acceleratori per l’intelligenza artificiale. Il 5 gennaio 2026 TrendForce stima per il primo trimestre un aumento dei prezzi della DRAM per server superiore al 60% rispetto al trimestre precedente.
Il rialzo prosegue per tutto l’anno. Secondo le stime della stessa TrendForce riportate da PMI.it, nel corso del 2026 i prezzi a contratto della DRAM per server crescono di circa il 270% cumulato. Dal terzo trimestre, aggiunge l’analista, la pressione si concentra sui clienti che non hanno firmato accordi di fornitura pluriennali, con rincari trimestrali tra il 13 e il 18%. Chi non è un hyperscaler compra memoria al prezzo che resta.
Attenzione perché, in un’infrastruttura virtualizzata, il listino si traduce subito in densità: in molti ambienti è la RAM, più della CPU, a decidere quante macchine virtuali può reggere un host. La domanda che un responsabile IT si pone oggi è concreta: che cosa si fa quando serve più memoria proprio nel momento in cui costa di più? Comprarla comunque, rimandare i progetti, oppure far rendere di più quella già installata. Sangfor ha scelto la terza strada.
Una pagina da 4 KB dentro Sangfor HCI
Il meccanismo si capisce meglio seguendo una singola pagina di memoria da 4 KB. L’architettura ha due livelli, governati da un modulo proprietario integrato nel kernel Linux: il Tier 0, o “Hot Tier”, è la DRAM fisica, che ospita i dati ad alta frequenza di accesso; il Tier 1, o “Cold Tier”, è un SSD NVMe ad alte prestazioni che il sistema tratta come memoria dedicata, con latenze nell’ordine dei microsecondi e IOPS elevati.
Funziona così: il modulo osserva gli accessi e ricostruisce l’insieme di lavoro effettivo di ogni carico, quello che Sangfor chiama Actual Working Set. La nostra pagina non viene toccata da un po’; esce dall’insieme di lavoro e viene declassata su NVMe, liberando DRAM per i dati più attivi. Poi una macchina virtuale la richiede. Il sistema la promuove di nuovo in DRAM, aggiorna la mappatura della memoria e restituisce il dato alla CPU. Le pagine calde, intanto, restano dove sono, con latenze nell’ordine dei nanosecondi. Il gioco sta tutto qui: tenere vicino al processore ciò che serve, e parcheggiare il resto.
La VM non se ne accorge. Applicazioni e sistemi operativi guest continuano a vedere uno spazio di memoria contiguo e non richiedono modifiche al codice; la gestione rispetta l’architettura NUMA, privilegiando la DRAM locale al processore e posizionando correttamente le pagine promosse. Il risultato si misura in capacità: 512 GB di DRAM affiancati da un disco NVMe diventano fino a 1 TB di RAM logica. La documentazione tecnica di Sangfor completa il quadro con strumenti di monitoraggio e osservabilità, che tracciano la distribuzione dei dati e le migrazioni tra i livelli e aiutano gli amministratori a pianificare la capacità.
Dove dà il meglio Sangfor
Sangfor indica con precisione dove la funzione rende di più, ed è un’indicazione utile per chi deve progettare un cluster. «La funzionalità è ottimizzata per scenari poco sensibili alla latenza, come ambienti di sviluppo e test, applicazioni da ufficio, file sharing, web server, API gateway e VDI 2D per uffici generici», spiega Protano; per i sistemi più critici, come «database core, sistemi di trading o altre applicazioni aziendali mission-critical ad alta priorità», la scelta consigliata resta la DRAM fisica.cSono andato a vedere i numeri che l’azienda ha pubblicato, e danno un ordine di grandezza interessante. In una prova sul blog di Sangfor, un database Oracle passa da 256 GB di memoria fisica a 128 GB di DRAM più 128 GB su NVMe: le transazioni al secondo passano da oltre 15.000 a circa 14.000. Metà della DRAM, una perdita intorno al 6-7%, su un carico più esigente di quelli per cui la funzione è pensata. Per gli ambienti di sviluppo, i web server o la VDI d’ufficio, dove gran parte della memoria allocata resta fredda per lunghi periodi, il margine è ancora più ampio.
Tradotto in termini di budget: un host che oggi avrebbe bisogno di un upgrade di memoria può raddoppiare la capacità logica con un SSD NVMe, rimandando l’acquisto di nuovi moduli o di nuovi nodi a un momento di mercato meno teso.
Di nuovo gli zeri
Torniamo al disco da cui eravamo partiti. Cold migration e cold clone sono le procedure con cui si spostano o duplicano le immagini disco delle macchine virtuali tra host o sistemi di storage diversi: si usano nei refresh dell’infrastruttura, nei cambi di piattaforma, nel riequilibrio dei carichi. In un progetto di uscita da VMware con centinaia di VM, sono l’attività che decide quante notti di manutenzione serviranno.
Fino alla release precedente Sangfor HCI usava sfscp, uno strumento proprietario sviluppato internamente per copiare immagini disco anche tra host differenti, già più veloce dei comuni tool di trasferimento. Il team R&D dedicato all’iperconvergenza ha però riprogettato l’intero workflow, sostituendolo con qemu-cp, un’utility ottimizzata specificamente per la migrazione delle immagini disco. Le novità sono due. La prima: qemu-cp elabora soltanto i dati utente realmente validi e ignora le aree sparse e le regioni a zero, senza bisogno di scansioni complete del disco; per molti workload enterprise il volume da trasferire si riduce fino al 90%. La seconda: un’elaborazione parallela basata su più coroutine sfrutta al massimo il throughput disponibile di storage e rete.
Gli effetti si vedono sul calendario. Una VM enterprise di dimensioni standard, che prima richiedeva diverse ore di fermo, si migra in meno di 20 minuti. Un progetto massivo da VMware a HCI, con centinaia di macchine virtuali, passa da diverse settimane a pochi interventi programmati nelle finestre serali.
Che cosa significa “5 volte” per un progetto di migrazione
Il dato viene da test comparativi side-by-side eseguiti in laboratorio su dischi con capacità tra 500 e 3.072 GB. Per chi deve pianificare una migrazione, conviene leggerlo dal lato dei vantaggi concreti. Il guadagno è massimo proprio dove le infrastrutture reali tendono a sprecare di più: nei dischi allocati generosamente e riempiti solo in parte, che sono la norma in molti ambienti enterprise. Qui qemu-cp evita di spostare centinaia di gigabyte di spazio vuoto. Sui dischi più pieni entra in gioco il parallelismo delle coroutine, che porta il trasferimento a sfruttare tutta la banda disponibile.
C’è poi il tema della continuità. Per i servizi che non possono fermarsi nemmeno per una finestra serale, la piattaforma affianca alla cold migration la warm migration non disruptive, che consente di spostare i carichi senza interruzioni. I due strumenti insieme coprono l’intero parco macchine: le VM che si possono spegnere viaggiano veloci, quelle che devono restare accese si spostano senza downtime.
Ora possiamo riprendere la frase messa da parte all’inizio, quella sulla consistenza a livello di byte tra origine e destinazione. Fra tutte le promesse del pacchetto è la più importante, perché una migrazione veloce vale qualcosa solo se il disco che arriva è identico a quello che è partito. Secondo Sangfor, la velocità di qemu-cp è costruita su questo vincolo: il motore salta gli zeri, mentre i dati reali arrivano a destinazione identici, byte per byte.
L’uscita da VMware come progetto industriale
Tutto questo accade in un mercato che ha cambiato forma il 22 novembre 2023, quando Broadcom ha chiuso l’acquisizione di VMware. Da allora il vendor ha eliminato le licenze perpetue e portato l’offerta su abbonamenti a pacchetti, un cambiamento che Digitalic ha seguito anche nell’articolo su VMware by Broadcom. Per molte organizzazioni il rinnovo è diventato il momento per valutare un’alternativa, e il nodo pratico è sempre lo stesso: quanto tempo, quanto rischio e quante interruzioni costa spostare l’infrastruttura esistente.
Su questo terreno Sangfor ha costruito la propria proposta, l’azienda, presente da anni nel canale italiano anche attraverso la distribuzione di Cometa, comunica di essere stata riconosciuta come Visionary nel Gartner Magic Quadrant for Server Virtualization Platforms 2026. Protano mette poi in fila gli elementi: «Grazie alla combinazione con un’esperienza operativa allineata a VMware, funzionalità di sicurezza native integrate e funzionalità di warm migration non-disruptive per le migrazioni senza interruzioni, questa capacità ottimizzata di cold migration e cloning offre un ulteriore strumento per rendere i progetti di sostituzione delle infrastrutture virtuali legacy più semplici, rapidi e a minor rischio».