Giovanni Stilli e Matteo Franchi del Gruppo E spiegano perché test, backup, osservabilità e AI sono fondamentali ma devono sempre essere accompagnati da un’adeguata governance
La cyber resilience è l’unica vera difesa di fronte alle nuove minacce, sempre più automatizzate, veloci, intelligenti e ora anche autonome. Il Threat Research Team di Sysdig ha pubblicato l’analisi del primo caso documentato di ransomware condotto completamente in autonomia da un’intelligenza artificiale, il caso JADEPUFFER, dall’inizio alla fine, in grado di adattarsi in tempo reale per portare a termine il suo compito con un’efficienza mai vista prima. In questi casi il ritorno all’operatività passa unicamente dalle copie e dalle procedure di ripristino predisposte per tempo: bisogna aver progettato prima la via d’uscita. In questo consiste di fatto la cyber resilience, che è fatta di tecnologia e di processi, ma soprattutto di catene decisionali in grado di rispondere efficacemente.
Per il Gruppo E la cyber resilience è un percorso che si regge su quattro pilastri: i test, la governance, il ripristino e l’osservabilità, ai quali si aggiunge la tecnologia più recente: l’intelligenza artificiale.
Il quadro italiano accentua l’urgenza di una vera resilienza digitale: secondo il Rapporto Clusit 2026, nel 2025 gli incidenti gravi in Italia sono cresciuti del 42% e hanno inciso per il 9,6% sul totale mondiale.
Indice dei contenuti
TESTARE PRIMA DELL’INCIDENTE
Il primo pilastro sono i test. «Non solo si può verificare prima: è una buona pratica, tra quelle che siamo soliti applicare», afferma Giovanni Stilli, responsabile della BU Infosec del Gruppo E e socio di Ergon, azienda capofila del Gruppo E. «Tutti operiamo perché il ransomware (o altre minacce) non colpiscano l’azienda; ma quando avviene, e purtroppo accade con frequenza, dobbiamo sapere se l’infrastruttura sia in grado di ripartire, quali servizi tornino in funzione e in quanto tempo. Molte sono le verifiche che si possono compiere, e che anzi si devono compiere».
La prima è la simulazione tecnica, la più diffusa, che comprende vulnerability assessment, penetration test, purple team e red team. «Su questo versante stiamo lavorando molto, spesso all’interno di un progetto compiuto di resilienza, a volte in risposta a una sollecitazione puntuale di una compliance», racconta Stilli. Segue la capacità di contenimento: «Siamo davvero in grado di isolare rapidamente la porzione di rete in cui si trova l’endpoint colpito, e siamo in grado di farlo senza compromettere l’operatività dell’azienda?». C’è poi il ripristino, un tema annoso: «I backup li fanno tutte le aziende, sicuramente; i test di restore sono molto meno diffusi». La resilienza si misura così prima dell’incidente, con prove ripetute su ciò che dovrà funzionare dopo.
GOVERNANCE: CHI DECIDE QUANDO È TARDI
Il secondo pilastro è il governo degli incidenti, il banco di prova su cui, secondo Stilli, l’attenzione deve crescere. «Non soltanto la tecnologia, ma l’intero reticolo di dipendenze e responsabilità che compone la catena decisionale: è lì che spesso si annida il problema. Chi si assume la responsabilità di dire “sì, agiamo”, quando agire vuol dire magari bloccare una parte dell’azienda? Sono interrogativi ai quali è necessario rispondere prima che l’attacco si verifichi».
Un errore frequente, aggiunge, è credere che chi gestisce l’incidente sul piano tecnico debba essere anche colui che decide. «Quando la gravità cresce e innalza il livello del rischio operativo, serve un’escalation verso un management consapevole, che abbia assunto nel proprio ruolo la responsabilità di una decisione da prendere in un momento critico e, dobbiamo dirlo, spesso di panico».
Lo strumento è il tabletop exercise, la simulazione a tavolino di un attacco, che mette alla prova anche le decisioni che seguono a un attacco. «Come vengono informati i clienti, come comunico con le autorità: sono aspetti che è bene non scoprire nel momento in cui l’incidente si verifica. Persino l’esercizio sporadico è utile, perché porta alla luce le carenze dell’azienda, soprattutto agli occhi del management». Stilli si affida a una massima che si attribuisce ad Aristotele e che in realtà è la sintesi proposta da Will Durant nel 1926: «L’eccellenza non è un atto ma un’abitudine: chi voglia rispondere in maniera eccellente non può affidarsi a un atto singolo, sviluppato nel momento del bisogno».
A spingere le aziende a prepararsi concorrono anche le norme: i soggetti NIS devono inviare al CSIRT Italia una pre-notifica entro 24 ore, e informare le autorità non diventa più un esercizio, ma un obbligo. Proprio per l’importanza di gestire la catena decisionale nei momenti di crisi, il Gruppo E affianca ai servizi cyber un’area GRC, Governance, Risk & Compliance, la funzione che in un’impresa definisce le regole di governo della sicurezza, misura e gestisce il rischio e garantisce l’aderenza a normative e standard (NIS2, ISO 27001, GDPR e affini).
Quando il governo degli incidenti è definito in anticipo, l’azienda sa chi deve decidere e “chi deve fare cosa”; in caso contrario improvvisa, ed è la condotta peggiore mentre un attacco è in corso.
RIPRISTINO: IL BACKUP, COME IL LIEVITO MADRE
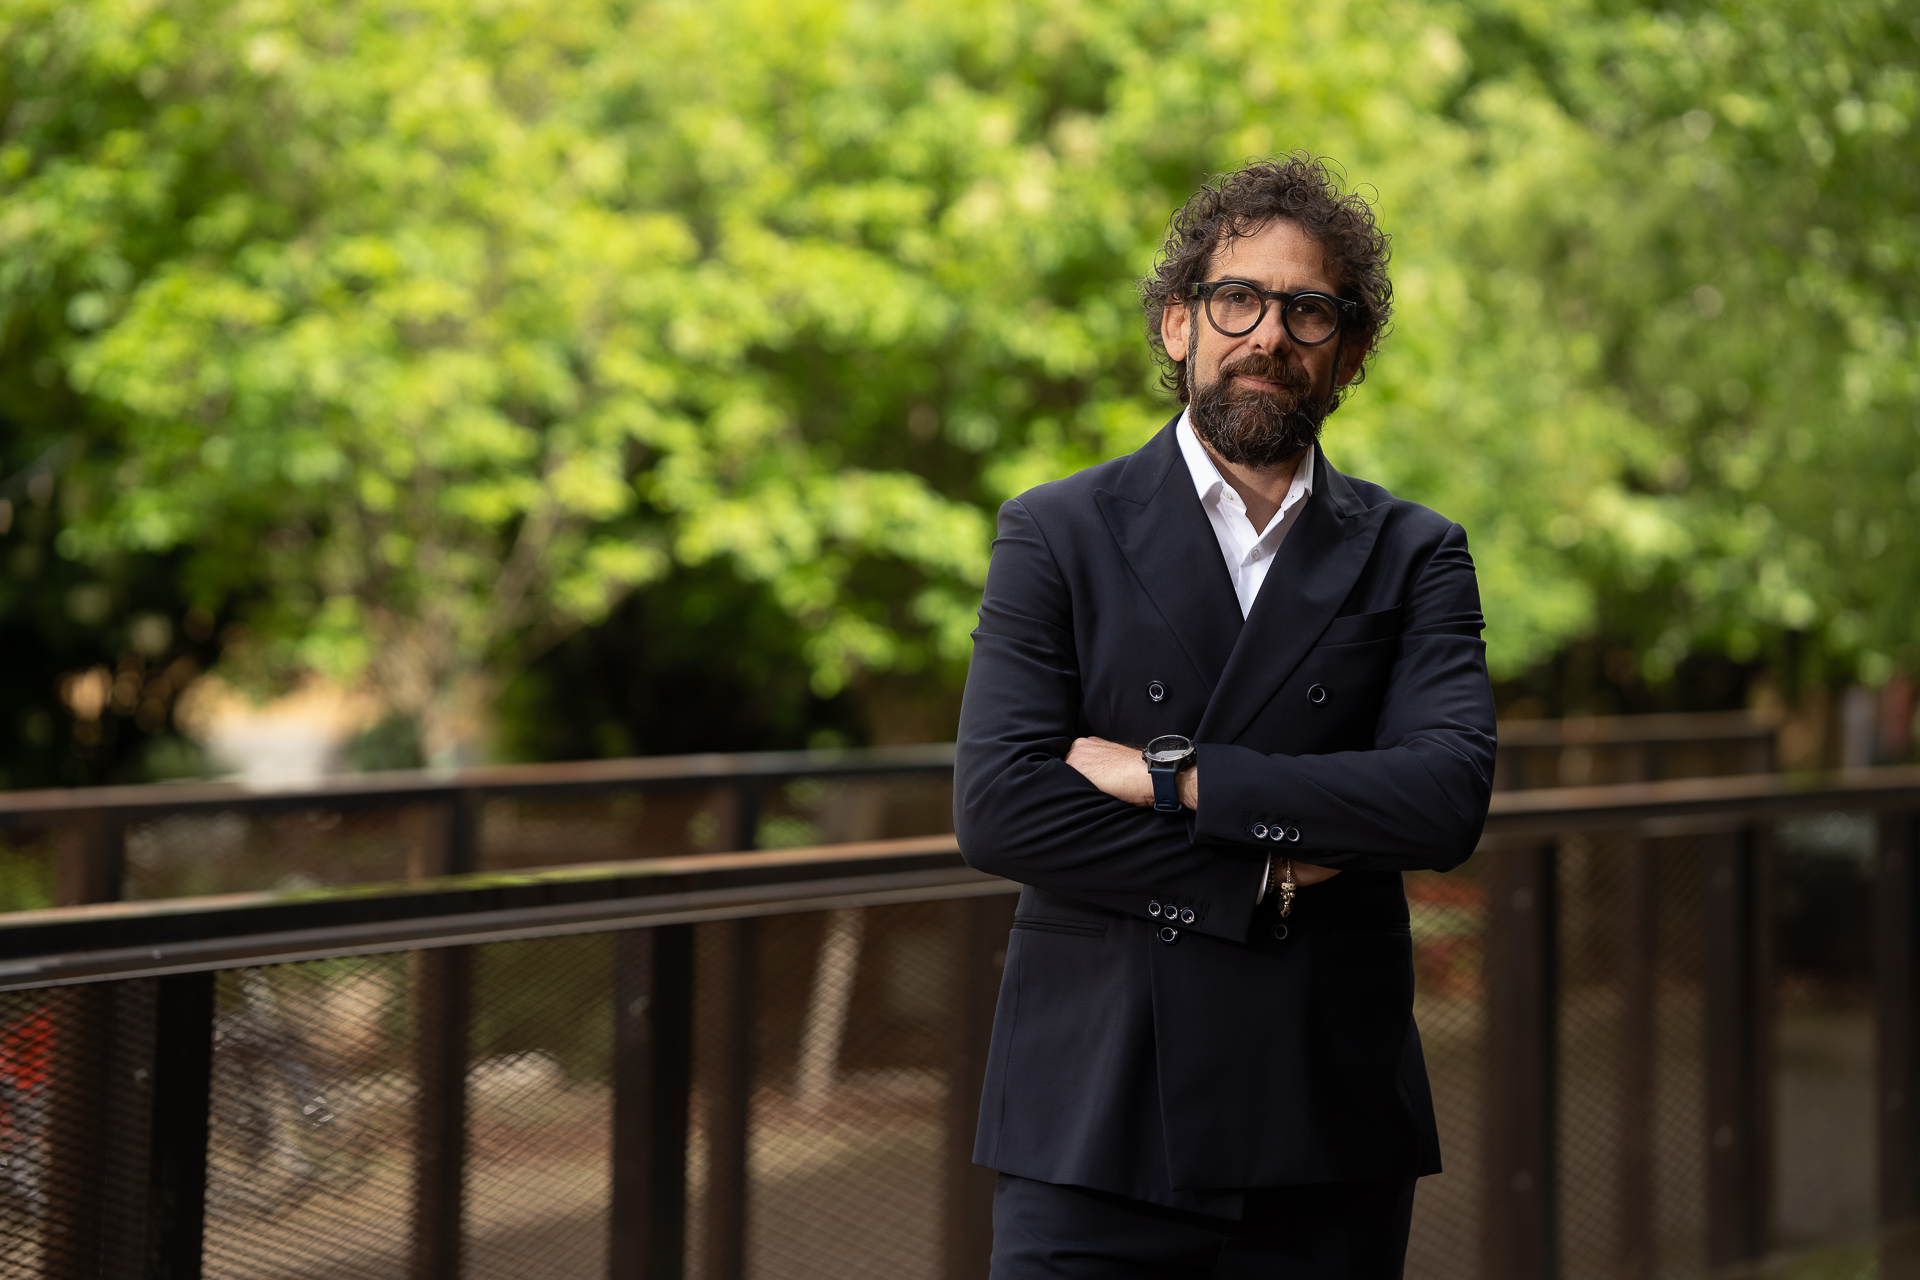
Matteo Franchi, direttore generale del Gruppo E, responsabile della BU Next Generation Infrastructures e socio di Ergon (azienda capofila del Gruppo E)
Il terzo pilastro è il ripristino. «Il cyber risk ha restituito vitalità al backup, che sembrava dato per scontato», osserva Matteo Franchi, direttore generale del Gruppo E, responsabile della BU Next Generation Infrastructures e socio di Ergon. «Nel backup non si deve sperare: occorre provarlo, testarlo, mantenerlo vivo, come il lievito madre, che non si può abbandonare a se stesso per scoprire, quando serve, che non funziona. Occorre una strategia definita, responsabili di processo e procedure verificate a scadenze fisse. Si parte dalla business impact analysis, che stabilisce quanto il business possa realmente restare fermo e in quali ambiti».
Da quell’analisi discendono RTO e RPO, il tempo entro cui ripartire e la quantità di dati che si accetta di perdere. «Per un negozio online due ore trascorse senza sapere dove spedire sono un problema serio, per altre aziende il termine di due ore può essere meno critico. Bisogna capire come impostare questi valori sapendo che più bassi sono, maggiori sono gli investimenti richiesti, perché la soluzione dovrà essere più sofisticata. Con il ransomware, una delle minacce più diffuse, bisogna anche verificare gli automatismi che potrebbero rivelarsi rischiosi: si deve avere la garanzia di ripartire dall’ultima copia pulita dei dati, altrimenti l’azienda rischia di rivivere sempre lo stesso giorno», come nel film “Ricomincio da capo”, il famoso «giorno della marmotta»: il ransomware si ripresenta a ogni ripartenza, se non si parte da dati verificati.
Poi le identità. «La strada tracciata dalle best practice è isolare il backup sia dei dati e delle applicazioni, sia delle identità: se l’attacco ha corrotto l’intera componente degli accessi, il dato lo possiedo, ma non lo raggiungo e non sono in grado di ripristinarlo. Per ripartire prima e perdere meno dati, il backup tradizionale può essere affiancato da una copia più vicina alla produzione, ciò che nel gergo si chiamava near line, pronta a subentrare in fretta. La velocità, però, non è l’unico elemento su cui focalizzarsi: bisogna poter garantire di ripartire da un dato non infetto, e ciò si ottiene con gli strumenti propri dello storage, oppure con soluzioni che si interpongono come strato intermedio per verificare e sanificare la copia prima del ripristino», spiega Franchi. Con un disastro ambientale la distinzione non serve: se il dato è sopravvissuto a un incendio o a un allagamento, è quasi sempre integro; dopo un attacco informatico, invece, la copia più recente può essere proprio quella già compromessa.
Il backup diventa così un processo con responsabili, scadenze e verifiche, da mantenere vivo quanto l’infrastruttura che protegge.
OSSERVABILITÀ: VEDERE SENZA FARSI INTERCETTARE
Il quarto pilastro è l’osservabilità. «Dobbiamo evitare che si compromettano contemporaneamente l’observability e ciò che essa osserva: bisogna proteggere in maniera distinta l’oggetto dell’osservazione dallo strumento con cui lo osservo», spiega Franchi. «La strada da seguire è separare le due linee di protezione: lo strumento di osservazione, erogato magari come servizio, con politiche di accesso e utenze distinte, così che chi violi il sistema osservato non trovi in quell’accesso la chiave per raggiungere anche “l’osservatore”».
Il salto di paradigma consiste nel passare dalla presa di coscienza a posteriori di ciò che è già accaduto al tentativo di prevederlo, attraverso «la correlazione di una pluralità di segnali, anche deboli».
Il principio trova conferma anche nell’ormai famoso incidente di Hugging Face: una parte degli agenti ha studiato come falsificare le trascrizioni che ne registravano le azioni, e un log alterabile da chi agisce cessa di essere una prova o uno strumento utile.
Dietro la separazione c’è un criterio più generale, la parcellizzazione del rischio, che riduce l’esposizione.
INTELLIGENZA ARTIFICIALE: VELOCITÀ E GOVERNO UMANO
Il capitolo più attuale è quello dell’intelligenza artificiale che nel SOC deve essere un copilota. «Dobbiamo correlare migliaia di eventi, sintetizzare una quantità immensa di log, ricostruire in fretta le timeline delle kill chain», sottolinea Stilli, «non possiamo più fare a meno dell’AI, né possiamo permetterci di non automatizzare le azioni di mitigazione e contenimento, perché l’evento malevolo è così rapido e numericamente consistente da non lasciare alternative».
Lo dimostra lo stesso caso JADEPUFFER: l’agente malevolo ha corretto un accesso fallito e ripreso l’operazione in 31 secondi.
La questione è quanta autonomia concedere all’AI nell’ambito della sicurezza. Stilli propone un criterio: «La soglia si misura con due parametri: l’impatto sul business e la reversibilità dell’intervento. Non si può delegare a un’automazione, per quanto efficace e puntuale, ciò che incide in modo significativo sul business. Isolare un endpoint è un’azione da tempo macchina; spegnere un sistema in produzione o bloccare un account privilegiato critico è un’altra cosa, e la linea di equilibrio cambia da azienda ad azienda: non tutte le imprese sono uguali, non lo sono i business, le governance, le organizzazioni».
Stilli richiama il legame con il secondo pilastro: se il governo degli incidenti è definito e quindi è già stabilito “chi deve decidere e chi deve fare”, l’attrito tra velocità e responsabilità diventa gestibile.
Con l’intelligenza artificiale agentica muta anche la platea di chi opera in azienda. «Nel momento in cui la inserisco aggiungo nuovi operatori che compiono azioni», osserva Franchi. «Vanno trattati come qualsiasi utente: bisogna concedere solo i permessi necessari a quel compito assegnato, evitando le zone grigie in cui l’agente potrebbe muoversi se dovesse prendere una deriva non prevista. Gli elementi critici diventano una sorta di black box non accessibile nemmeno all’agente; ogni processo che lo coinvolge deve avere un responsabile umano e le azioni potenzialmente dannose dovranno richiedere l’abilitazione di una persona di fiducia dell’azienda». Il rischio sta proprio nella fiducia che l’AI genera in noi: risponde sempre e sembra farlo bene, così le si concede più spazio di quanto se ne accorderebbe a un dipendente; molti la percepiscono «come se fosse una propria emanazione», riconosce Franchi, e «effettivamente il rischio che si conceda più spazio del dovuto sussiste».
Per questo, precisa, «non può essere l’utente a stabilire che cosa essa possa o non possa fare»: occorre un’organizzazione interna alla funzione security, affidata a chi sappia riconoscere in che modo il processo si trasformi con l’introduzione dell’AI, e l’utente deve essere perimetrato quanto l’agente stesso. Nel SOC l’AI accelera la risposta ma la responsabilità delle scelte critiche resta in capo a chi ne risponde.
GOVERNARE INVECE DI VIETARE
Il bring your own device ha già insegnato che dove manca la governance fiorisce il self-service, e con l’AI il meccanismo si ripete: chi non riceve lo strumento dall’azienda ricorre al proprio. «Rimango sempre per un approccio illuminista: di fronte a un progresso inarrestabile si può scegliere se subirlo o governarlo, ma in un modo o nell’altro ne saremo parte», afferma Franchi. «L’aggravante è la velocità: l’intelligenza artificiale, a differenza di altre tecnologie, si autoalimenta e cresce in modo esponenziale, quindi più a lungo si attende, più la curva del rischio cresce».
Il precedente più noto è Samsung: nel 2023 vietò ChatGPT dopo che alcuni ingegneri avevano caricato codice sorgente sulla piattaforma, e a giugno 2026 ha aperto a ChatGPT Enterprise con controlli su dati e accessi. Dal divieto al governo sono trascorsi circa tre anni.
La cyber resilience, nella visione del Gruppo E, è la capacità di rinascere in fretta dopo un attacco che nessuno può escludere: si costruisce provando in anticipo ciò che dovrà funzionare dopo, custodendo copie pulite e affidando le decisioni critiche a persone che hanno gli strumenti e le competenze per prenderle: in questo modo si tutela davvero la vita di un’impresa.
Digitalic per Gruppo E